

谷歌昨天的动作可不小,直接甩出了全新的轻量级AI模型:Gemini 3.1 Flash-Lite。这次谷歌算是把“快”和“省”这两个字给玩明白了,直接定位为Gemini 3系列里速度最快、成本最低的那个选择。
目前,开发者已经能通过Google AI Studio里的Gemini API拿到预览版,企业用户也可以在Vertex AI平台上直接开整。
价格屠夫来了,门槛直接拉低
为了让更多人能用得起大模型,谷歌这次把价格压到了一个相当有诚意的水平。每百万输入Tokens收费仅需0.25美元,输出Tokens则是1.50美元。说白了,这个价格对那些高频调用API的开发者和初创企业来说,绝对是个极具诱惑力的选项。
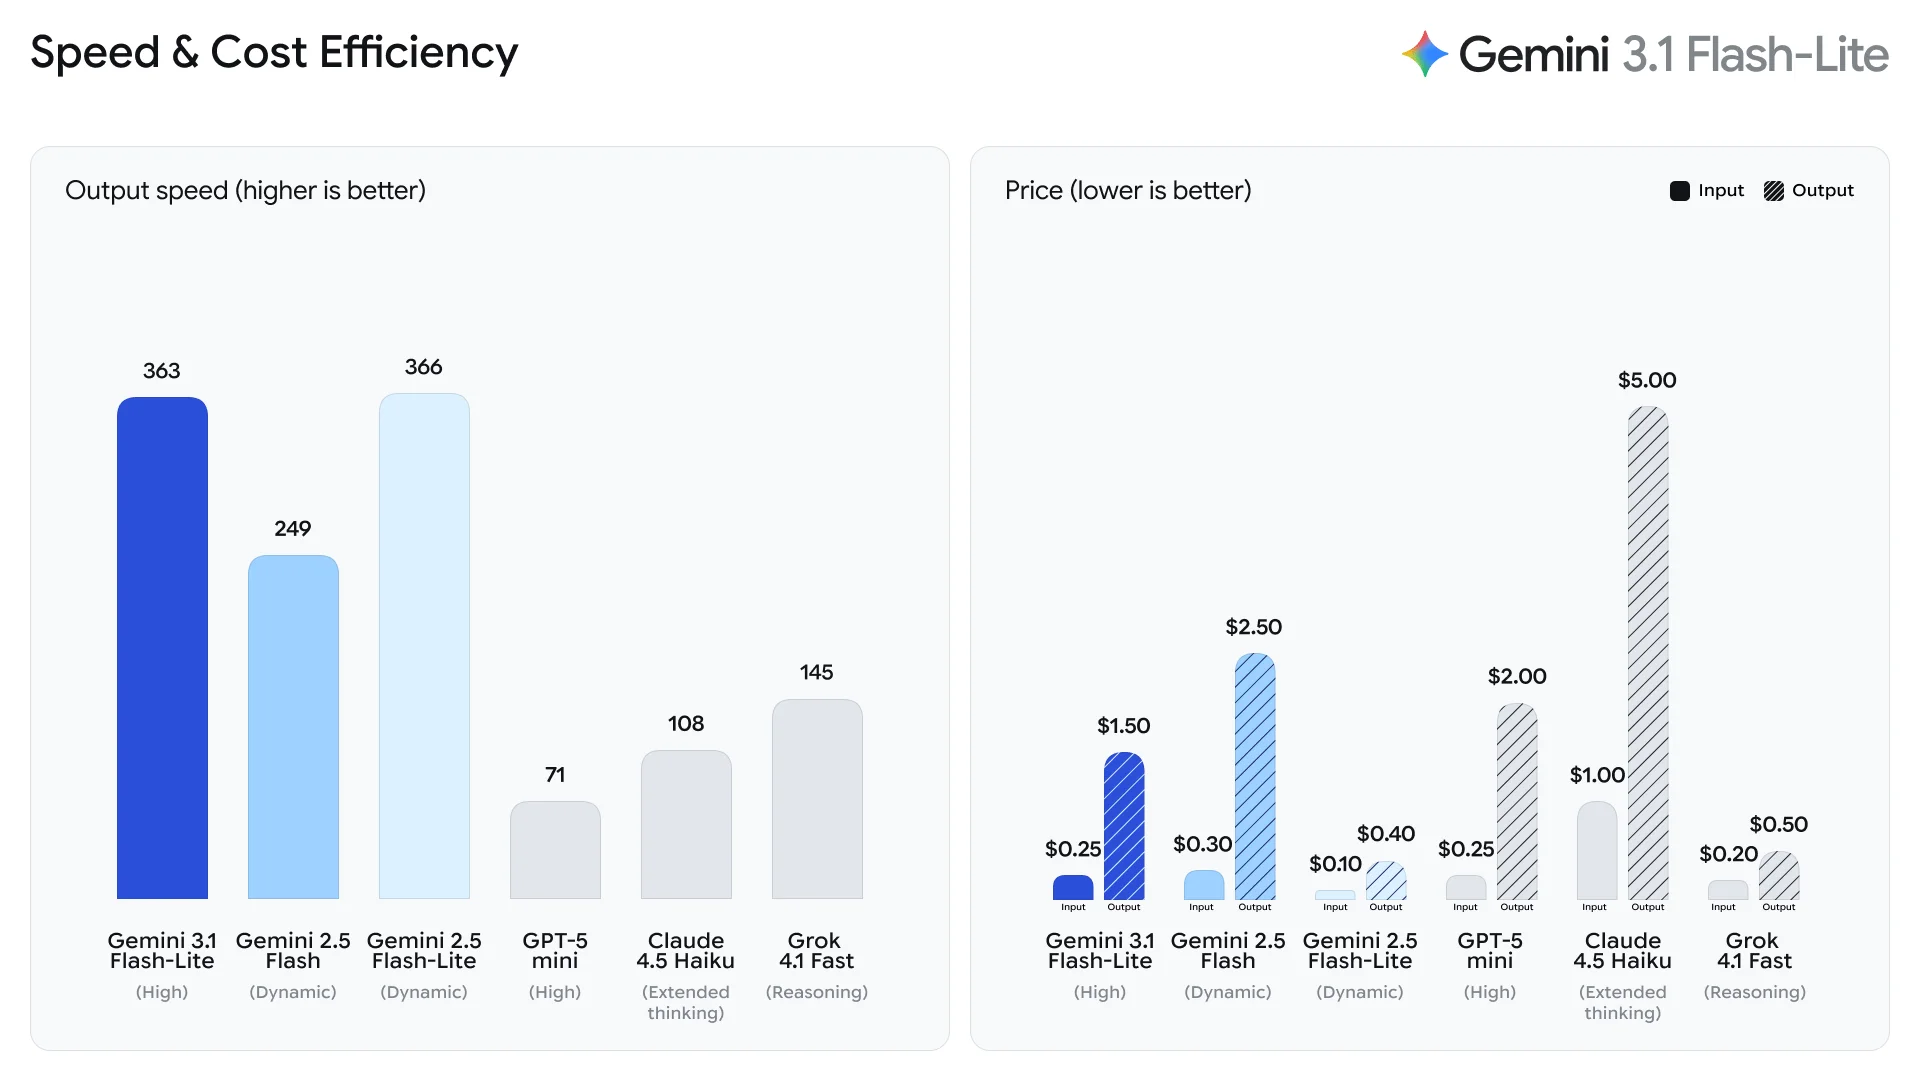
别看它叫“Lite”,性能上却是一点没妥协。根据Artificial Analysis的数据,这哥们儿比上一代2.5 Flash强多了。首字响应速度直接暴涨2.5倍,整体输出速度也提了45%。这种极致的低延迟,就是为了那些需要实时交互的应用场景量身定做的。
越级挑战的硬核实力
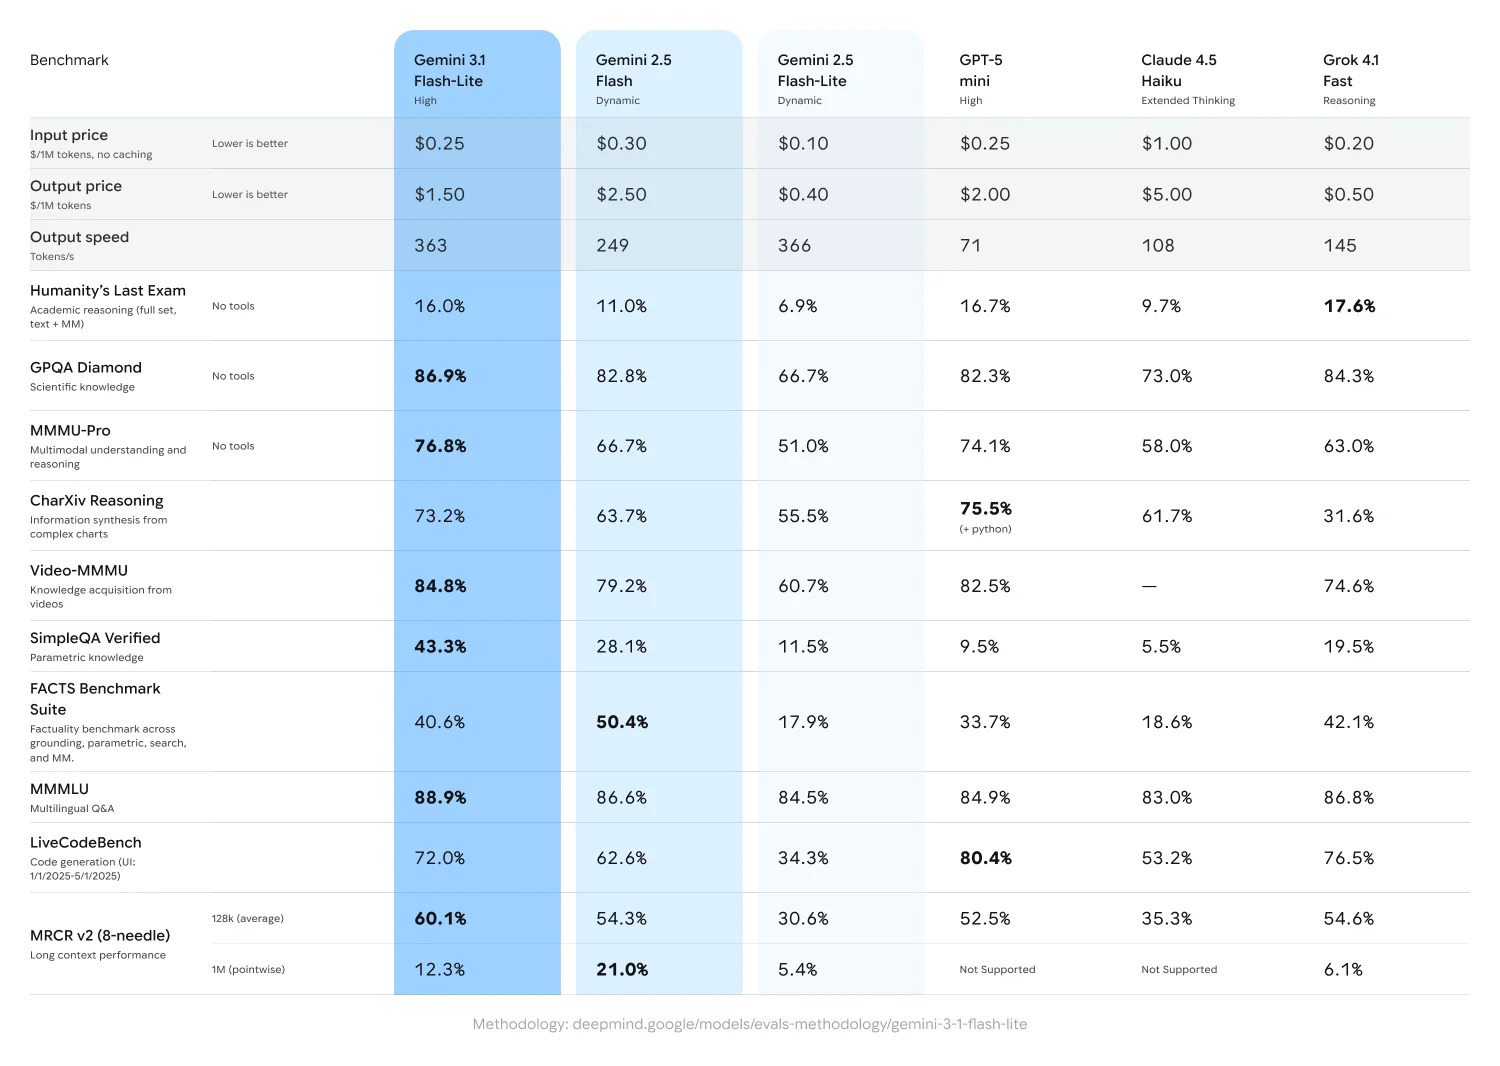
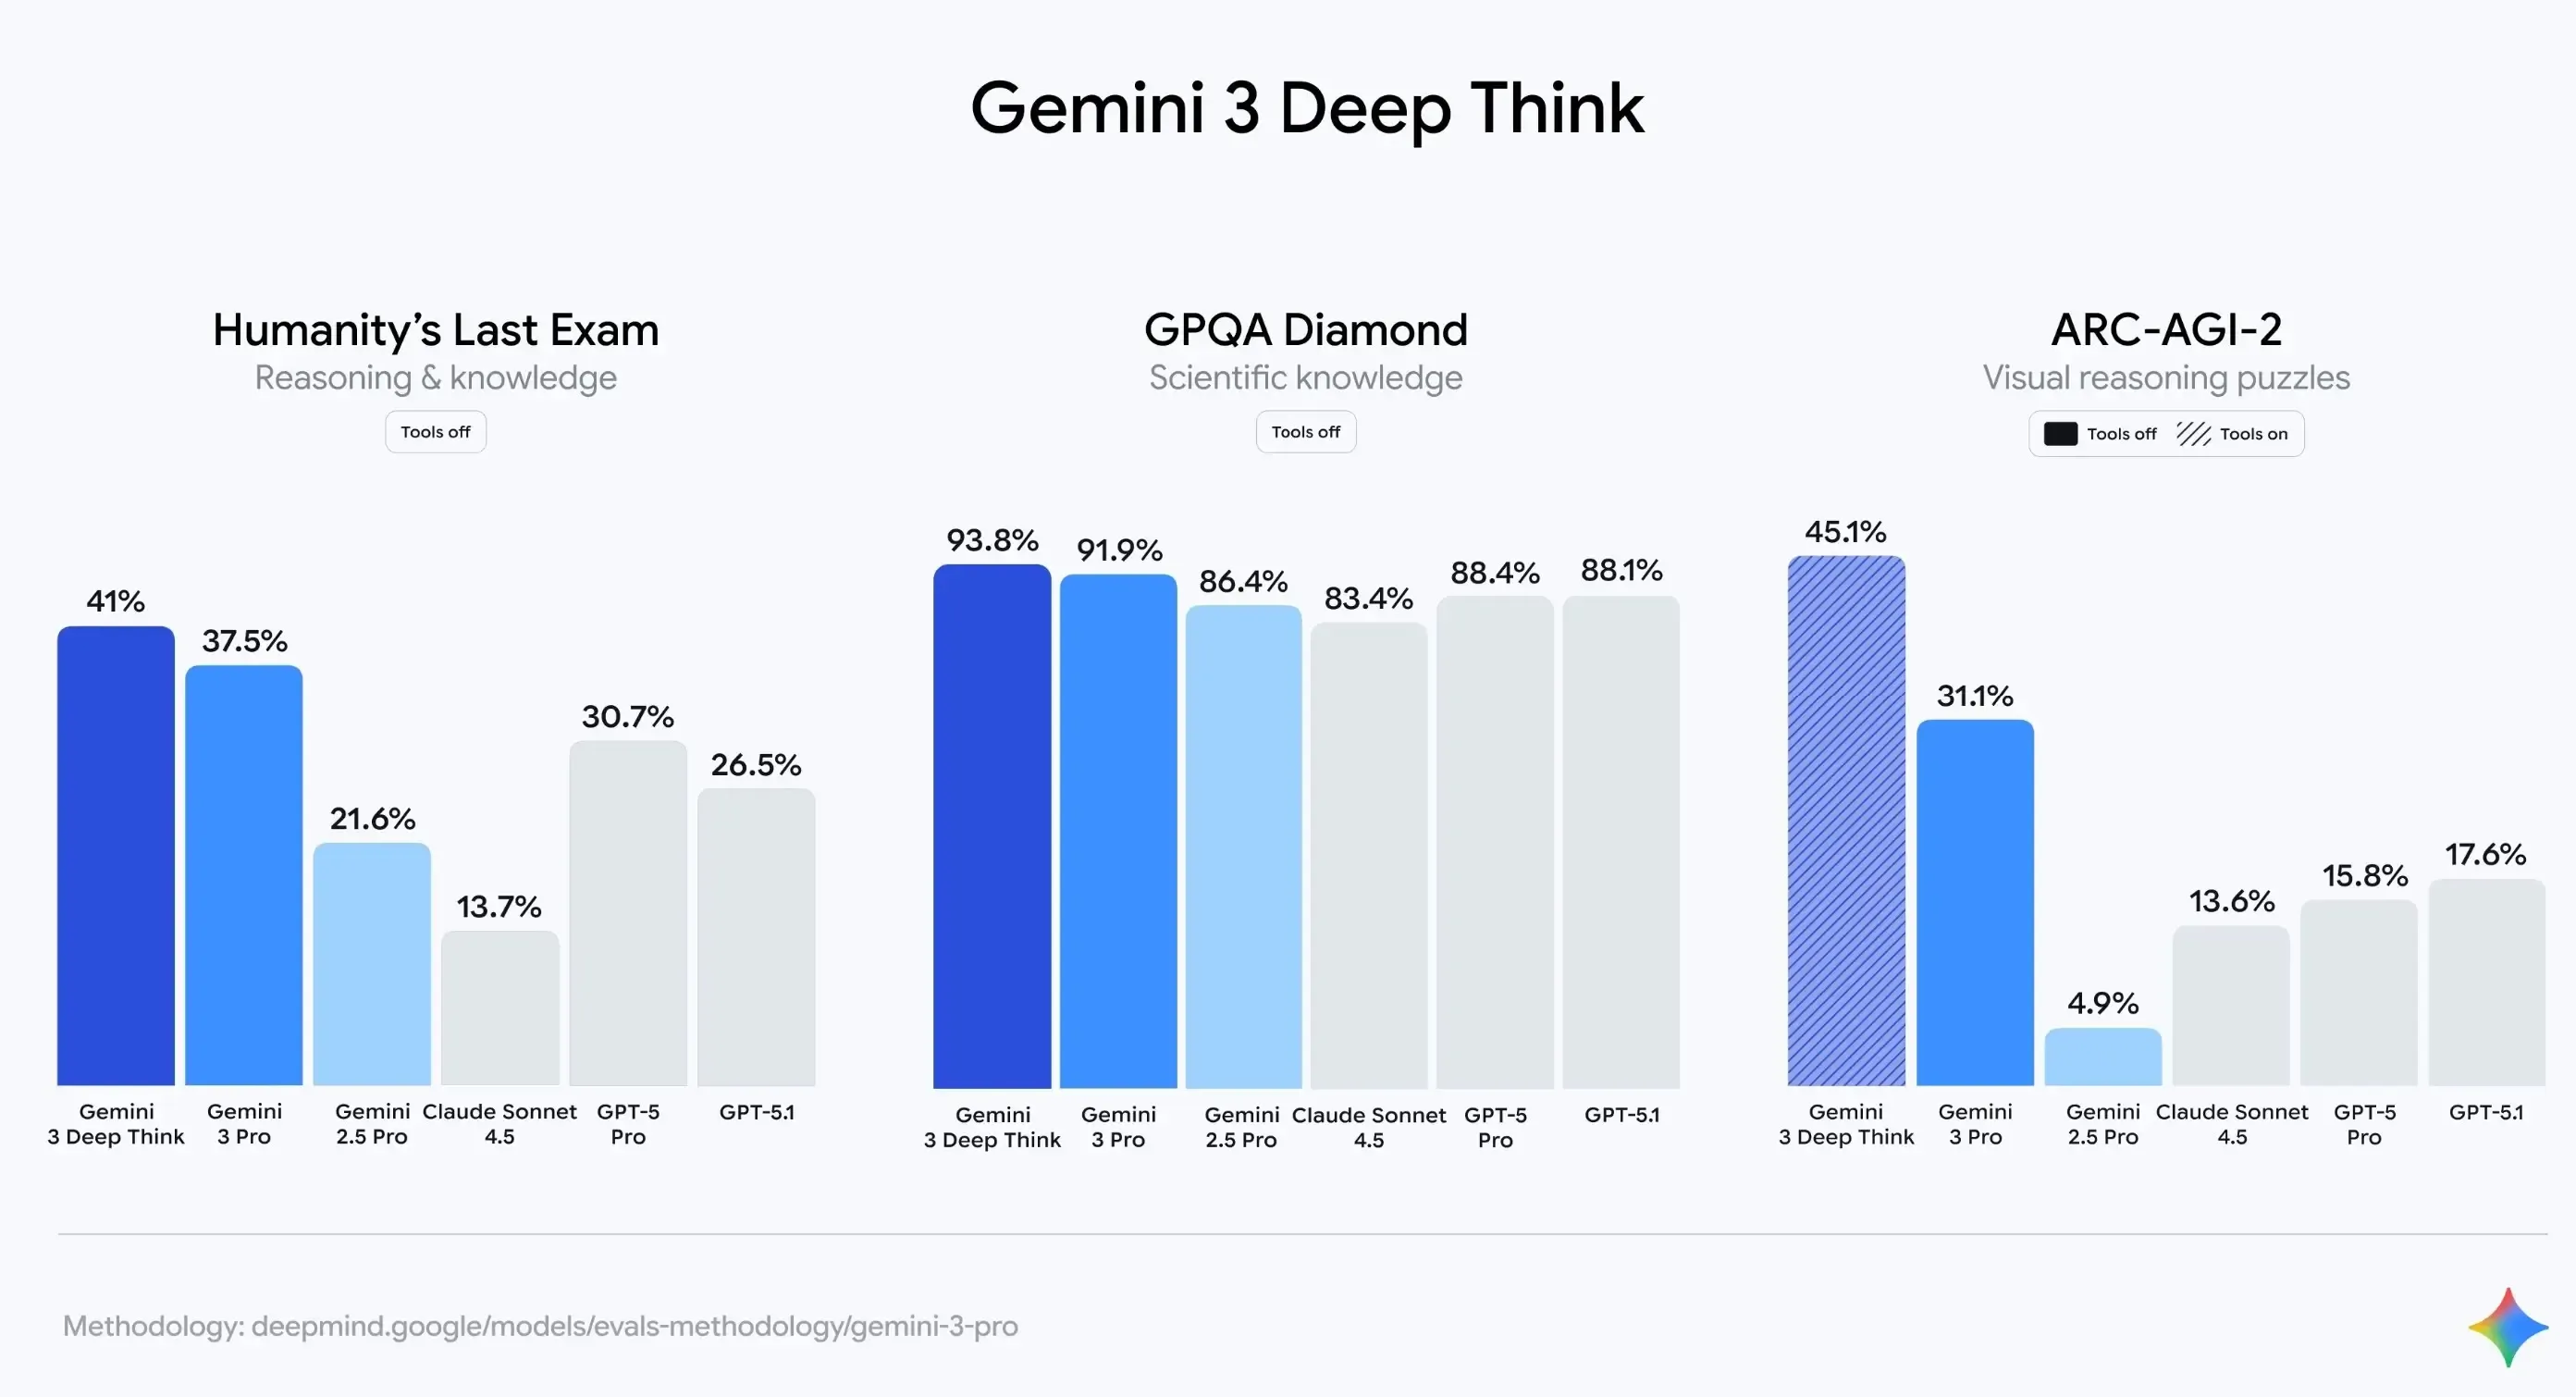
在核心能力上,3.1 Flash-Lite的表现甚至有点“犯规”。在Arena.ai排行榜上,它直接拿到了1432分的Elo得分。到了硬核测试环节,比如GPQA Diamond测试得分高达86.9%,MMMU Pro测试也有76.8%。甚至在多项指标上,它直接把上一代大哥Gemini 2.5 Flash给压下去了。
创新的“思考层级”:灵活掌控AI大脑
搬主题觉得这次最有意思的更新,其实是那个“思考层级(thinking levels)”功能。
谷歌给了开发者一个控制AI“深度”的开关:
- 省钱省力版:如果是处理翻译、内容审核这种基础且量大的任务,你可以把思考深度调低,追求极致的响应效率。
- 深度推理版:要是遇到生成界面、构建数据看板或者复杂的逻辑模拟,你就能调高思考层级,逼着模型开启“深思熟虑”模式,解决复杂难题。
像Latitude、Cartwheel这些早期的企业用户已经在用它干活了。反馈回来的消息是,这模型既有大模型的精准度,处理效率还高得惊人。对于开发者来说,这种可控的推理能力,无疑是构建复杂业务逻辑时的利器。如果你正愁AI应用成本太高或者响应太慢,这个新模型倒是值得重点关注一下。









暂无评论内容