


AI 智能摘要
DeepSeek-V4开源了,分Pro和Flash两个版本。Pro是全能选手,编程和Agent能力很强,接近顶级闭源模型。Flash主打快和便宜,日常任务够用。两个版本都支持百万字超长上下文,靠新的注意力机制实现,处理大型文档更轻松了。API已经更新,记得及时修改调用模型名哦。
DeepSeek 刚刚搞了个大动作,全新的 DeepSeek-V4 模型系列正式上线并同步开源了!这次升级主打一个“百万字超长上下文”体验,对于咱们这些整天和代码、文档打交道的开发者来说,确实是个值得关注的消息。
两个版本,各有千秋
这次DeepSeek-V4按模型大小分成了 Pro 和 Flash 两个版本,虽然都是为了解决长上下文问题,但侧重点完全不同。
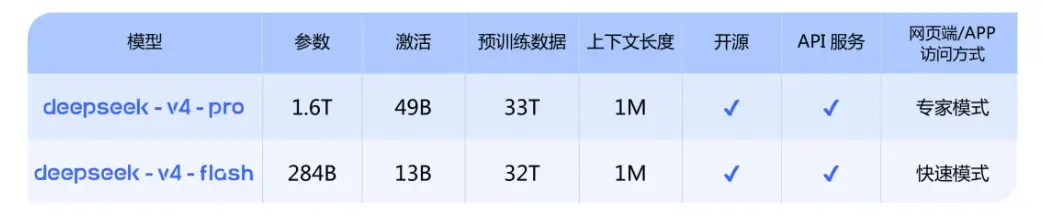
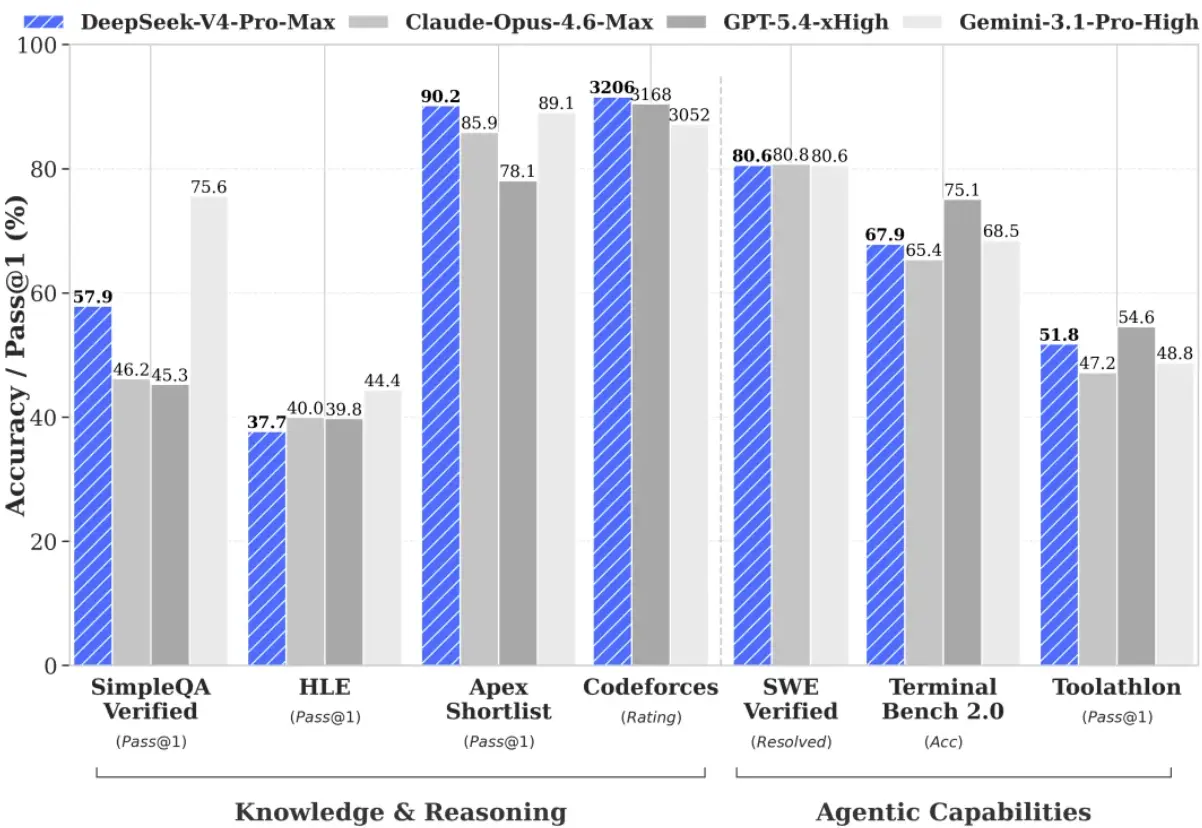
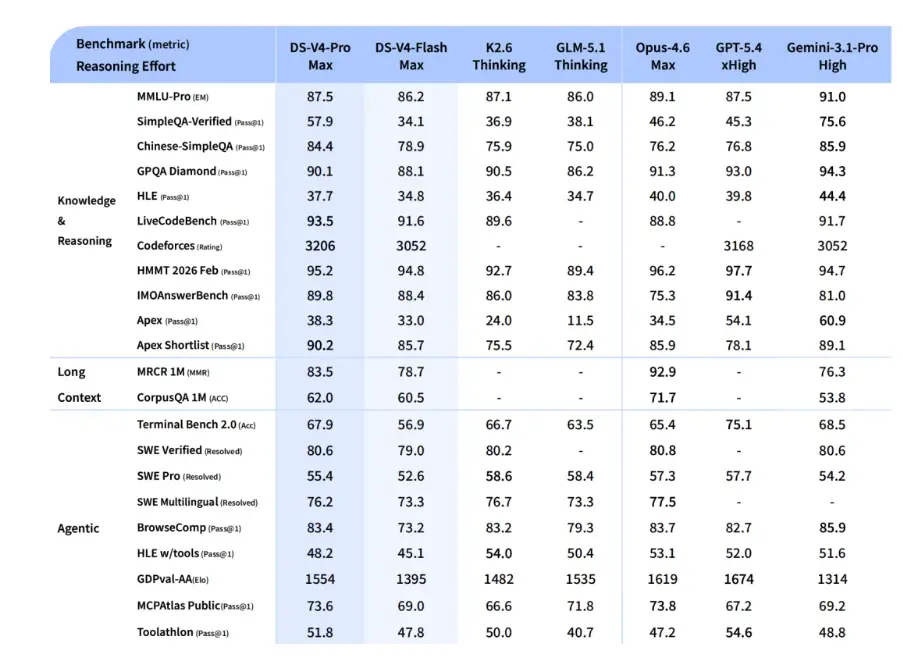
- DeepSeek-V4-Pro:这就是妥妥的“六边形战士”。不仅Agent能力显著增强,在Agentic Coding评测里直接拿到了开源模型里的天花板成绩,甚至据内部反馈,用起来比Sonnet 4.5还要爽,交付质量逼近Opus 4.6非思考模式。世界知识储备方面也相当硬核,仅次于Gemini-Pro-3.1。说白了,如果你需要处理高难度的编程任务、复杂的STEM逻辑或者竞赛级代码,选它准没错。
- DeepSeek-V4-Flash:如果你追求极致的性价比和速度,Flash版本就是首选。虽然知识储备稍逊一筹,但推理能力依然在线。最关键的是,它的参数和激活量更小,API调用起来又快又省钱。简单任务它跑得跟Pro没啥区别,性价比极高。
黑科技:1M 上下文成标配
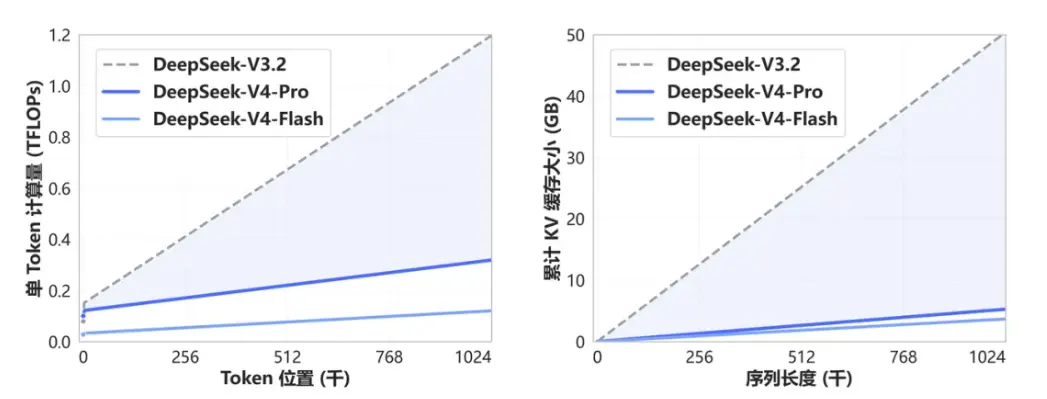
这次DeepSeek-V4能跑动1M(一百万)上下文,靠的是一种全新的注意力机制。它在token维度做了压缩,再加上DSA(DeepSeek Sparse Attention)稀疏注意力技术,在实现全球领先的长记忆能力的同时,还大大降低了对计算和显存的需求。说白了,以前跑不动的大型文档分析,现在不仅能跑,还跑得更经济实惠了。
给开发者的避坑指南与适配建议
现在API服务已经同步更新,大家访问的时候要注意啦:
- Base_url 保持不变,只需要把
model参数改成deepseek-v4-pro或deepseek-v4-flash。 - 它支持 OpenAI ChatCompletions 和 Anthropic 接口,接入起来很方便。
- 两个版本都支持“思考模式”,在处理复杂Agent场景时,建议把
reasoning_effort设置为max,效果会好很多。
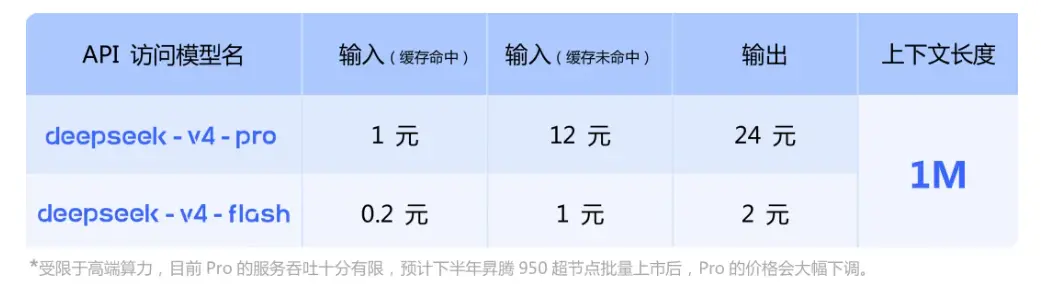
搬主题提醒大家,旧有的 API 接口模型名 deepseek-chat 和 deepseek-reasoner 将在三个月后(2026年7月24日)正式下线。虽然目前这两个旧名称还指向 V4-Flash 的对应模式,但为了长远考虑,大家还是趁早把代码里的模型调用名称改过来,免得三个月后网站莫名其妙报错,到时候排查起来就麻烦了。
DeepSeek-V4 这次针对 Claude Code、OpenClaw 等主流 Agent 产品都做了专门优化,尤其是代码和文档生成任务,体验提升非常明显。其实吧,这种“超长记忆”加“强推理”的组合,对于经常需要阅读几十万行代码或者厚重技术文档的开发者来说,确实能省下不少心力。感兴趣的朋友现在就可以登录官网体验一下,或者去 API 后台跑跑看,毕竟工欲善其事,必先利其器。
© 版权声明
THE END















暂无评论内容