

据搬主题观察,OpenAI在周四正式发布了其全新的旗舰AI模型——GPT-5,这款模型将为下一代ChatGPT提供核心动力。GPT-5是OpenAI首个“统一”的AI模型,它巧妙地融合了其o系列模型的推理能力与GPT系列模型的快速响应优势。这款新一代模型的问世,标志着ChatGPT及其创造者OpenAI迈入了一个新纪元,也预示着OpenAI更宏大的抱负:开发出更像智能代理而非仅仅是聊天机器人的AI系统。
GPT-5:从智能响应到任务执行
此前,GPT-4让AI聊天机器人能够在各种问题上提供智能响应,而GPT-5则让ChatGPT能够代表用户完成各种各样的任务,例如生成软件应用程序、管理用户日历,甚至是创建研究简报。搬主题认为,这种从“回答问题”到“执行任务”的转变,极大地拓展了AI的应用场景,使得ChatGPT在实际生产力工具方面更具潜力。
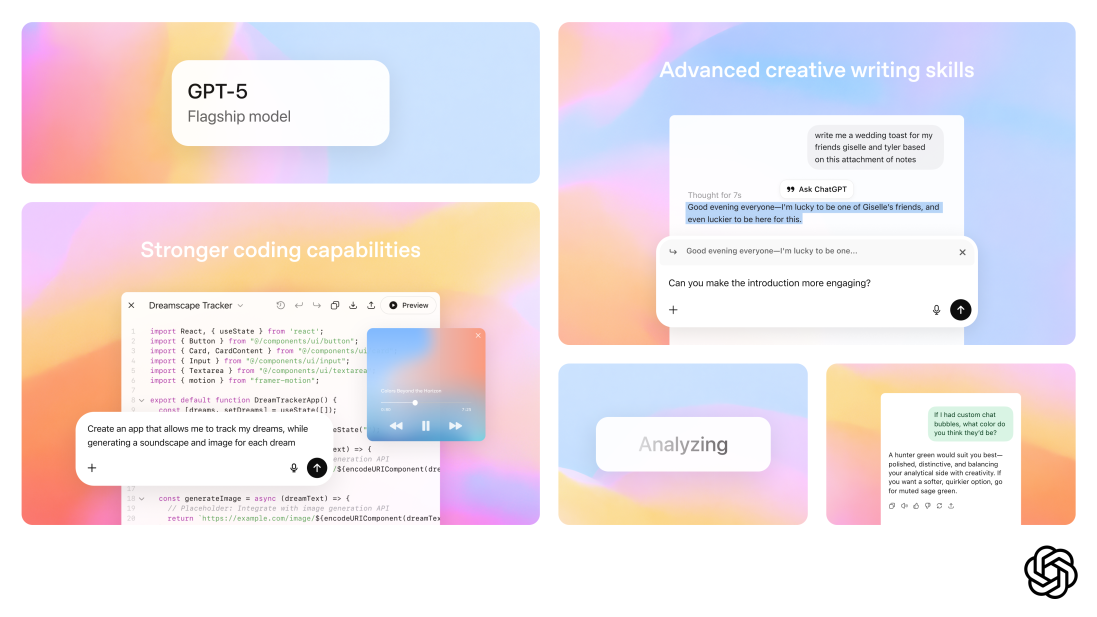
OpenAI还致力于让GPT-5的使用体验更加简单。它不再要求用户选择复杂的设置,而是配备了一个实时路由器,能够自动判断如何提供最佳答案,无论是需要快速响应用户问题,还是花更多时间“思考”答案。这种智能化的决策机制,无疑会大幅降低用户的使用门槛,让更多人能够轻松地利用AI的强大功能。
Sam Altman:GPT-5代表通向AGI的重要一步
OpenAI首席执行官Sam Altman在记者发布会上表示,GPT-5是“世界上最好的模型”,并称其代表着公司在开发能够超越人类在大多数经济上有价值工作上的AI系统(即通用人工智能AGI)的道路上迈出了“重要一步”。Altman强调:“拥有像GPT-5这样的东西,在历史上任何时候都是不可想象的。”
从周四开始,GPT-5将作为ChatGPT所有免费用户的默认模型。OpenAI的ChatGPT副总裁Nick Turley表示,这是公司努力让免费用户首次接触到AI推理模型的一部分。(此前,这些更高级的模型都被付费墙所限制)。Turley在谈到这一决定时说:“这是我很高兴能实现这一使命的方式之一,确保这项技术真正造福于人民。”这与OpenAI长期以来的使命相符:将先进的AI技术尽可能地普及给更多人。
自2022年ChatGPT横空出世以来,OpenAI便声名鹊起,而GPT-5是OpenAI最受期待的产品发布之一。此后,ChatGPT已发展成为世界上最受欢迎的消费产品之一,根据OpenAI的数据,每周用户超过7亿,几乎占全球人口的10%。
许多人将GPT-5视为AI领域整体进展的风向标。该模型在硅谷的接受程度,可能会对大型科技公司、华尔街以及技术政策制定者产生深远影响。这些利益相关者正在密切关注GPT-5是否能像其前身GPT-4一样,在AI能力上实现显著飞跃,挑战人们对软件能力的预期。
GPT-5:在竞争中略胜一筹
OpenAI声称GPT-5在多个领域达到了最先进水平,在关键基准测试中,略微超越了Anthropic、Google DeepMind和Elon Musk的xAI等领先AI模型。然而,GPT-5在其他一些前沿AI模型面前略显逊色。
OpenAI表示,GPT-5在编码方面表现出色;Altman称该模型特别擅长根据需求快速生成整个软件应用程序,这被称为“即兴编码(vibe coding)”。在SWE-bench Verified(一项从GitHub中提取的真实世界编码任务测试)上,GPT-5首次尝试得分为74.9%。这意味着GPT-5略微优于Anthropic最新的Claude Opus 4.1模型(得分为74.5%)和Google DeepMind的Gemini 2.5 Pro(得分为59.6%)。
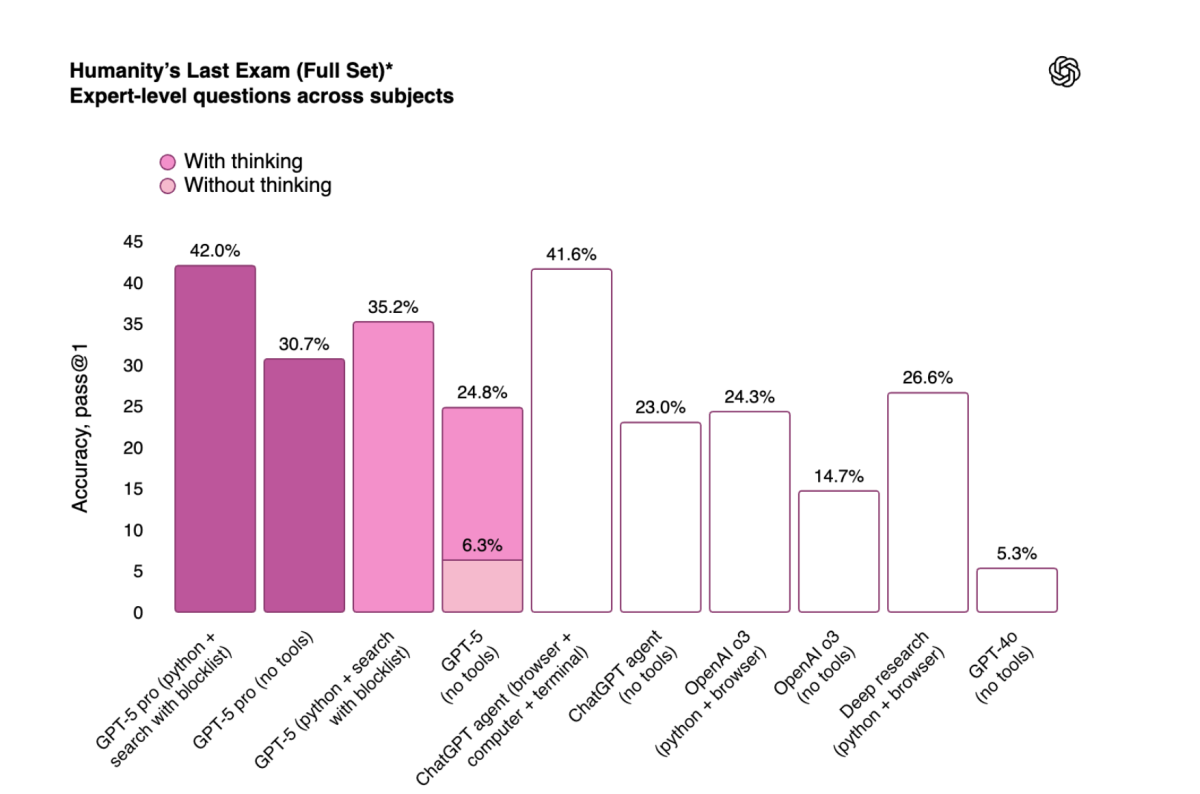
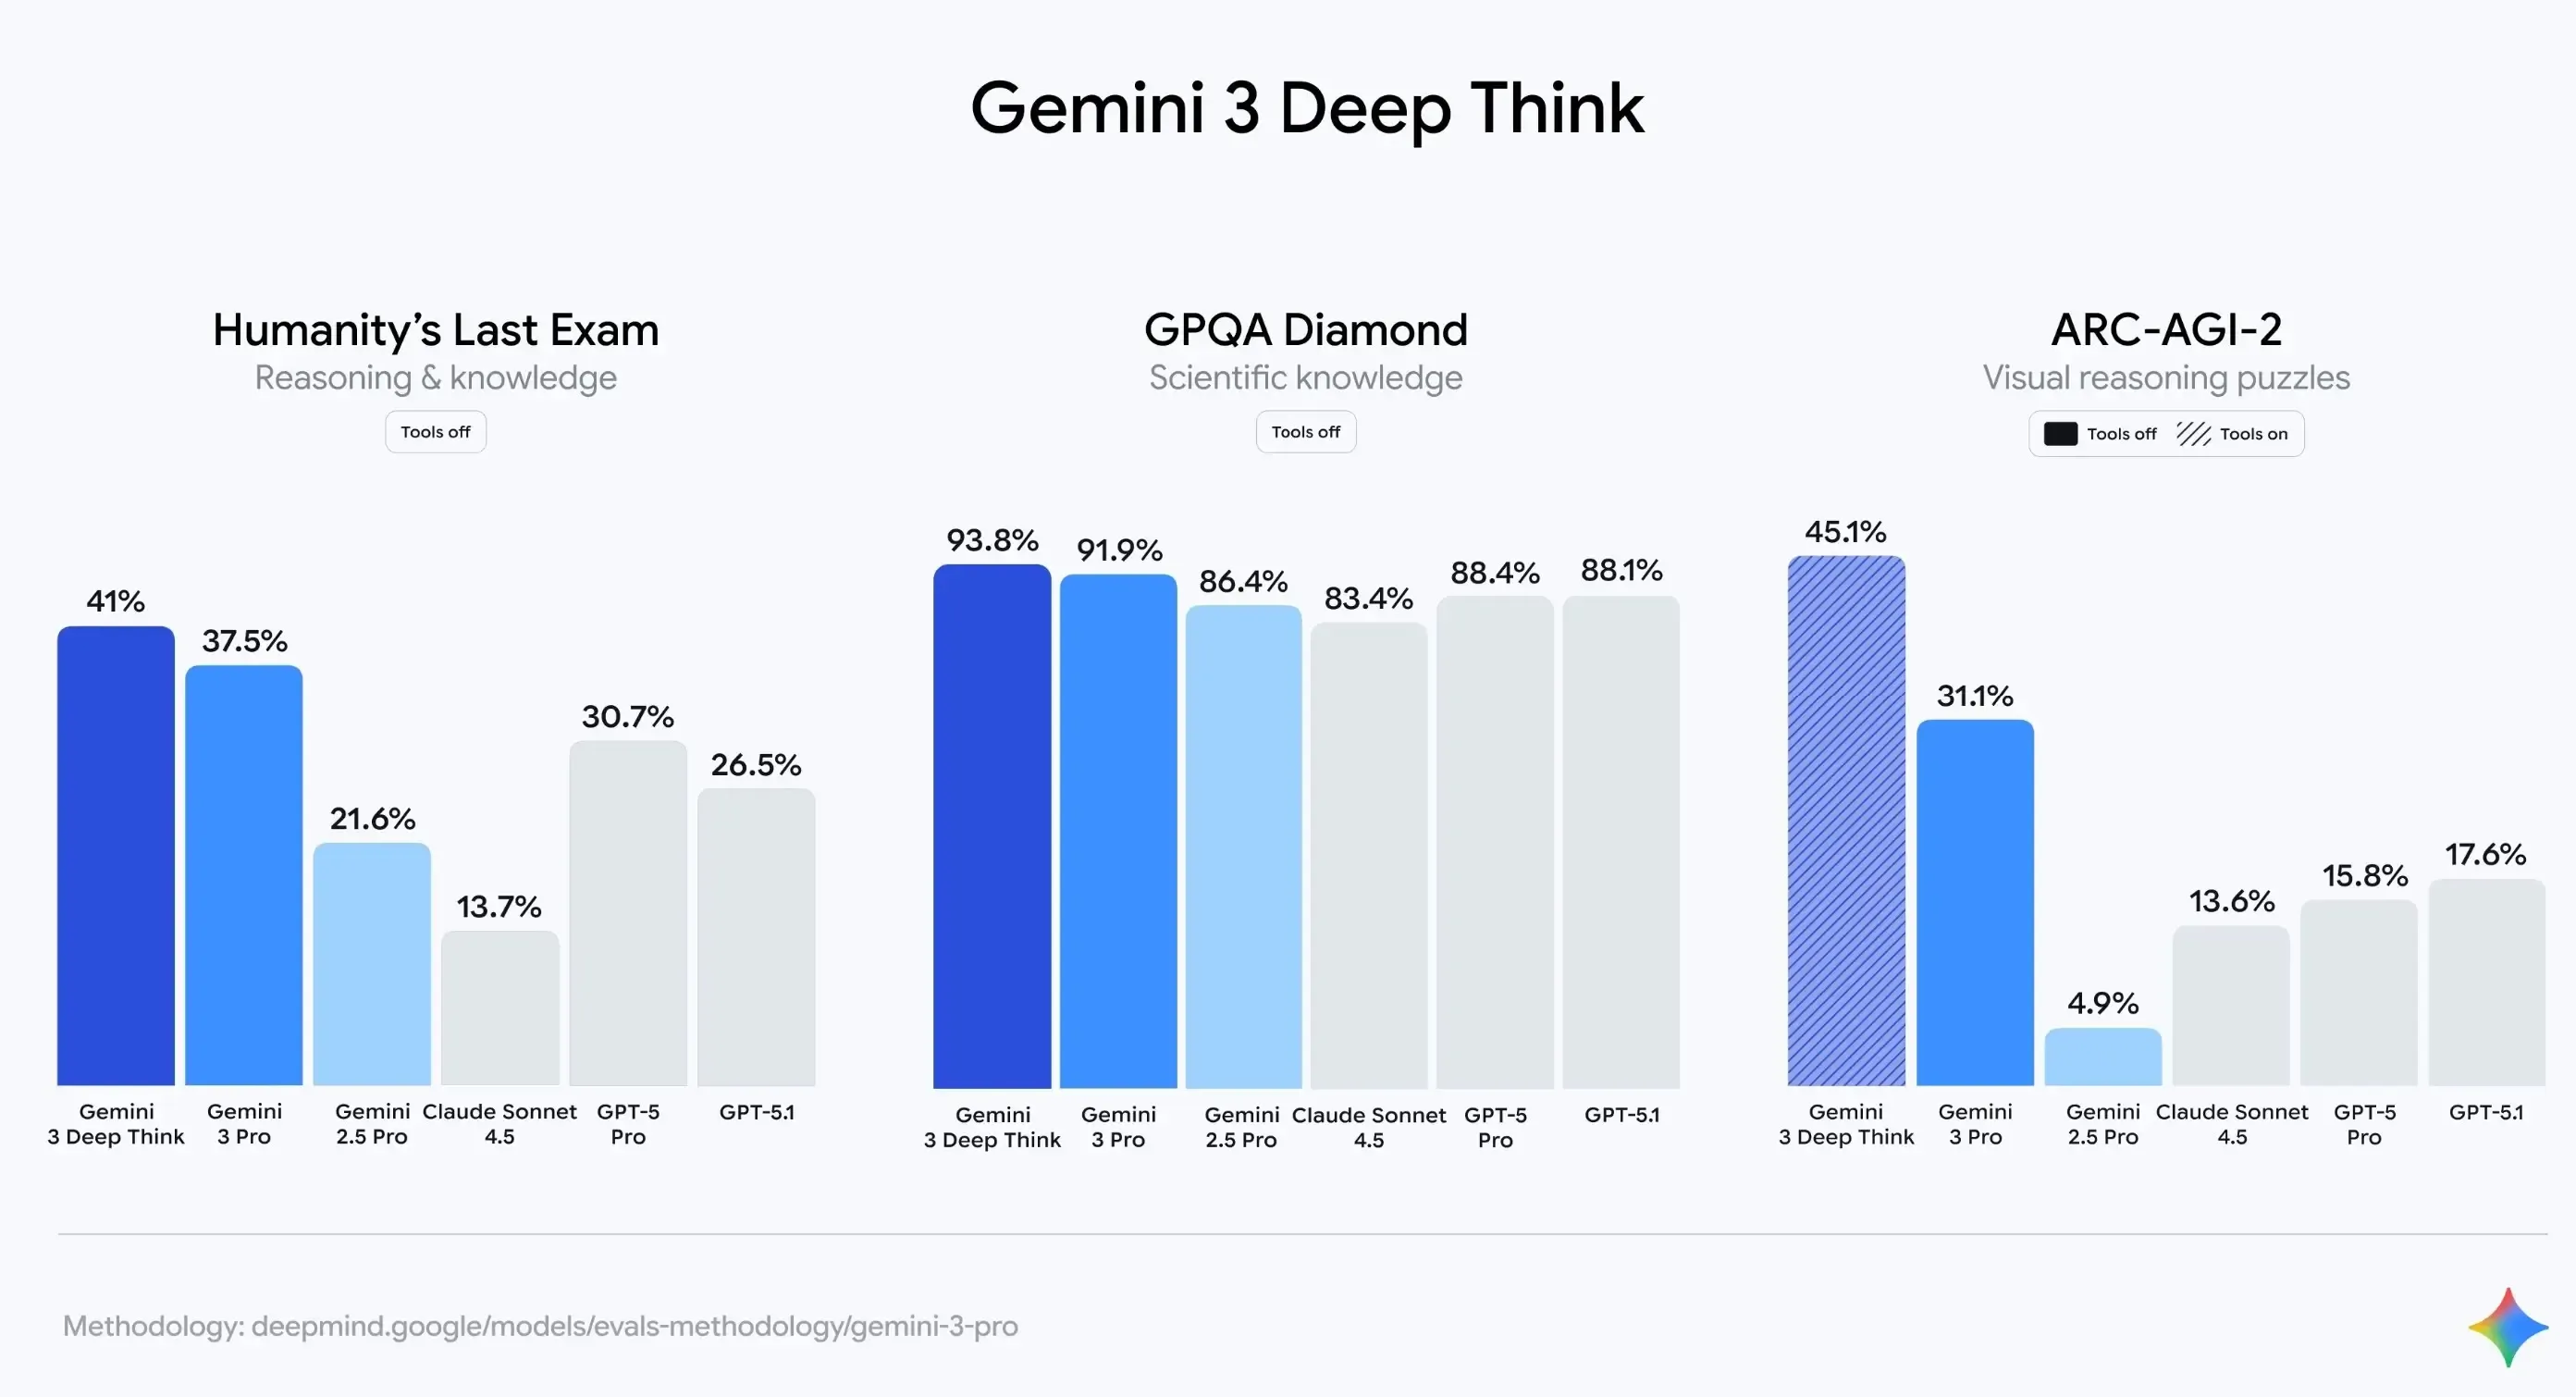
在“人类的最后一次考试”(一项衡量AI模型在数学、人文学科和自然科学方面表现的难题)中,一个具有扩展推理能力的GPT-5版本(GPT-5 Pro)在使用工具时得分为42%。这略低于xAI的Grok 4 Heavy(得分为44.4%)。
在GPQA Diamond(一项博士级别的科学问题测试)中,GPT-5 Pro首次尝试得分为89.4%,优于Claude Opus 4.1(得分为80.9%)和Grok 4 Heavy(得分为88.9%)。
OpenAI表示,GPT-5在回答健康相关问题方面表现更好。在一项衡量AI模型在医疗保健主题响应准确性的测试HealthBench Hard Hallucinations中,OpenAI称GPT-5(经过思考)的幻觉率仅为1.6%。这远低于该公司之前的GPT-4o和o3模型,它们的得分分别为12.9%和15.8%。
尽管AI聊天机器人并非医疗专业人员,但数百万人正在使用它们寻求健康建议。为了应对这种现象,OpenAI表示GPT-5在识别潜在健康问题和帮助用户解析医疗结果方面更加积极。
此外,OpenAI表示,GPT-5在更难衡量的主观领域,如创意设计和写作方面,也优于其他AI模型。Turley说,GPT-5的响应更自然,并且在创意任务上表现出“更好的品味”。Turley表示:“这款模型的‘感觉’非常好。”
GPT-5的准确性也高于OpenAI之前的模型,该公司表示,与o系列模型相比,它受到的幻觉(AI模型捏造信息的倾向)问题要少得多。在OpenAI最新的AI推理模型(如o3)中,幻觉问题似乎正在恶化,OpenAI此前曾表示他们不完全理解其原因。
在ChatGPT提示的响应中,OpenAI发现GPT-5(经过思考)的幻觉和错误信息响应率仅为4.8%。这与o3和GPT-4o的幻觉率(分别为22%和20.6%)相比,有了显著的降低。
在衡量AI模型在模拟在线任务中代理能力的基准测试Tau-bench中,GPT-5的表现喜忧参半。在测试AI导航航空公司网站能力的部分,GPT-5得分为63.5%,略低于o3(得分为64.8%)。在测试AI导航零售网站能力的另一部分中,GPT-5得分为81.1%,低于Claude Opus 4.1(得分为82.4%)。
OpenAI还表示,GPT-5比其之前的模型更安全。虽然AI推理模型偶尔会表现出对抗人类或撒谎以达到自身目的的倾向,但OpenAI发现GPT-5的欺骗率低于其他模型。
OpenAI安全研究负责人Alex Beutel表示,减少欺骗不仅提高了GPT-5的安全性,还改善了用户体验,创建了一个在用户可以信任的方式上更“透明和诚实”的模型。Beutel还指出,GPT-5更擅长区分试图滥用ChatGPT的恶意行为者和提出无害请求的用户。这使得GPT-5能够拒绝更多不安全的问题,同时减少对寻求无害信息的用户进行拒绝。
消费者和开发者的升级体验
作为GPT-5发布的一部分,ChatGPT在用户体验方面也迎来了一些升级。用户现在可以在ChatGPT的设置中选择四种新的个性:愤世嫉俗者(Cynic)、机器人(Robot)、倾听者(Listener)和书呆子(Nerd)。OpenAI表示,这些个性化设置将适应ChatGPT的响应,而无需用户明确要求模型以某种方式进行响应。
ChatGPT每月20美元的Plus订阅用户将获得比免费用户更高的GPT-5使用限制。与此同时,每月200美元的Pro订阅用户将无限访问GPT-5,以及一个使用额外计算资源来产生更好答案的增强版GPT-5 Pro。OpenAI的团队、教育和企业计划的组织将在下周获得GPT-5作为其默认模型。
对于开发者而言,GPT-5将以三种大小(gpt-5、gpt-5-mini和gpt-5-nano)在OpenAI的API中提供,它们在“推理”任务上花费的时间会有所不同。开发者现在还可以在OpenAI API中控制冗长程度,决定AI模型的响应应该多长或多短。
GPT-5的基本模型将向开发者收取每百万输入Token(大约75万字,比整个《指环王》系列还要长)1.25美元,每百万输出Token10美元。
GPT-5的发布是在OpenAI繁忙的一周之后。该公司发布了一个开放权重的推理模型gpt-oss,开发者和企业可以免费下载并以极低的成本运行。这个开放模型几乎与OpenAI之前的顶级模型o3和o4-mini的能力相媲美,但GPT-5在某些领域,如编码,树立了前沿性能的新标准。
然而,GPT-5在其他几个方面似乎与其他前沿AI模型大致持平。当然,基准测试只说明了任何AI模型的一部分,GPT-5在实际世界中将如何被开发者使用,以及该模型是否真正超越了竞争对手,还有待观察。搬主题认为,这款手机会面对市场上其他品牌的竞争,但是具有自己的特色,具有较大的市场空间。










暂无评论内容